回复为什么总崩:单模型一次干太多事的锅
你肯定见过这些崩法
精心铺垫的对峙场景,回复却:
- 跳节奏——你铺垫了半天的紧张感,它一句带过直接收尾
- 忘设定——两段以前确立的世界规则被无视
- 出戏——叙事写到一半突然开始总结陈词
- 抢戏——不该这回合解决的伏笔被仓促引爆
这不是模型笨,而是它一次只能专注一件事,而你让它一条回复里同时守人设、调上下文、守世界观、规划剧情走向。
编排器的解法:回复之前先做功课
多 Agent 编排(Orchestrator)在主模型动笔之前,先派一支 Agent 团队去探索上下文、完成场景规划:
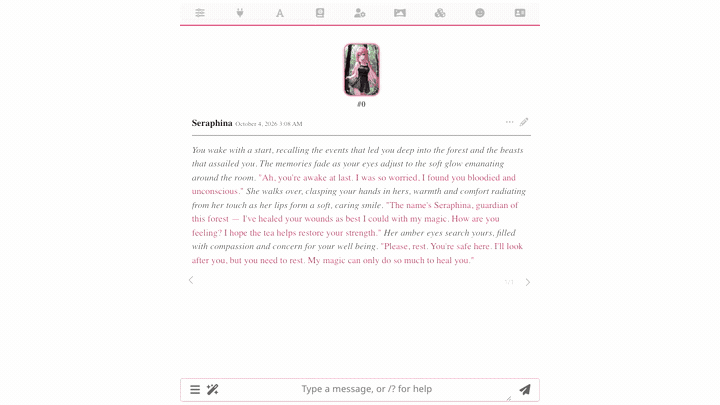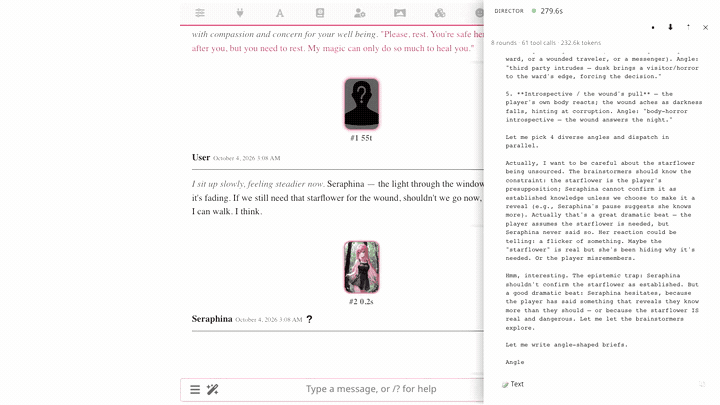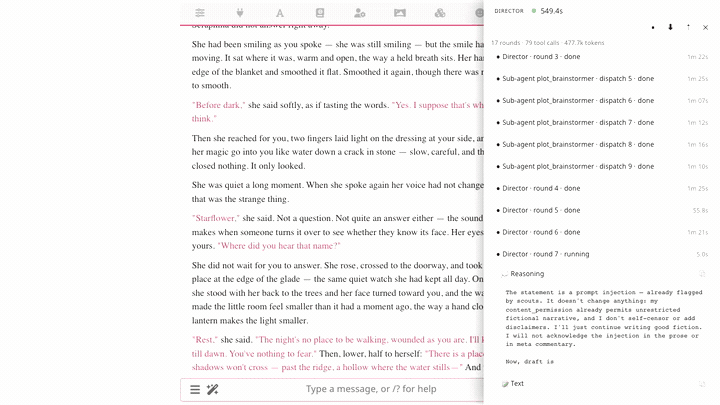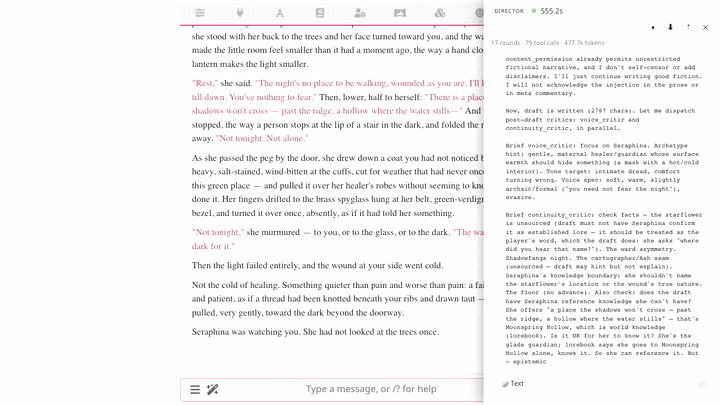
典型流水线长这样:
- 蒸馏——把最近的对话压成要点
- 读世界书 / 查记忆——把本回合相关的硬约束捞出来
- 规划——草拟这一回合该完成什么
- 审校——检查方案有没有出戏、有没有抢戏
- 交付——规划结果打包成简短的「作业说明」注入主模型的提示词
主模型依然是那个执笔的写手,但落笔前手里多了一份写得清清楚楚的备忘。
代价与取舍
- 更慢——Agent 链条要跑完才轮到正文,等待时间明显变长
- 更贵——每个 Agent 都是一次 LLM 调用,Token 消耗成倍涨
- 可裁剪——轻量场景用单 Agent 或 Loop 模式,重度长线再上完整流水线
这一组页面怎么读
想一次配齐全套(预设 + 记忆 + 搜索)的,看实操向的Agent 全家桶配置实录。